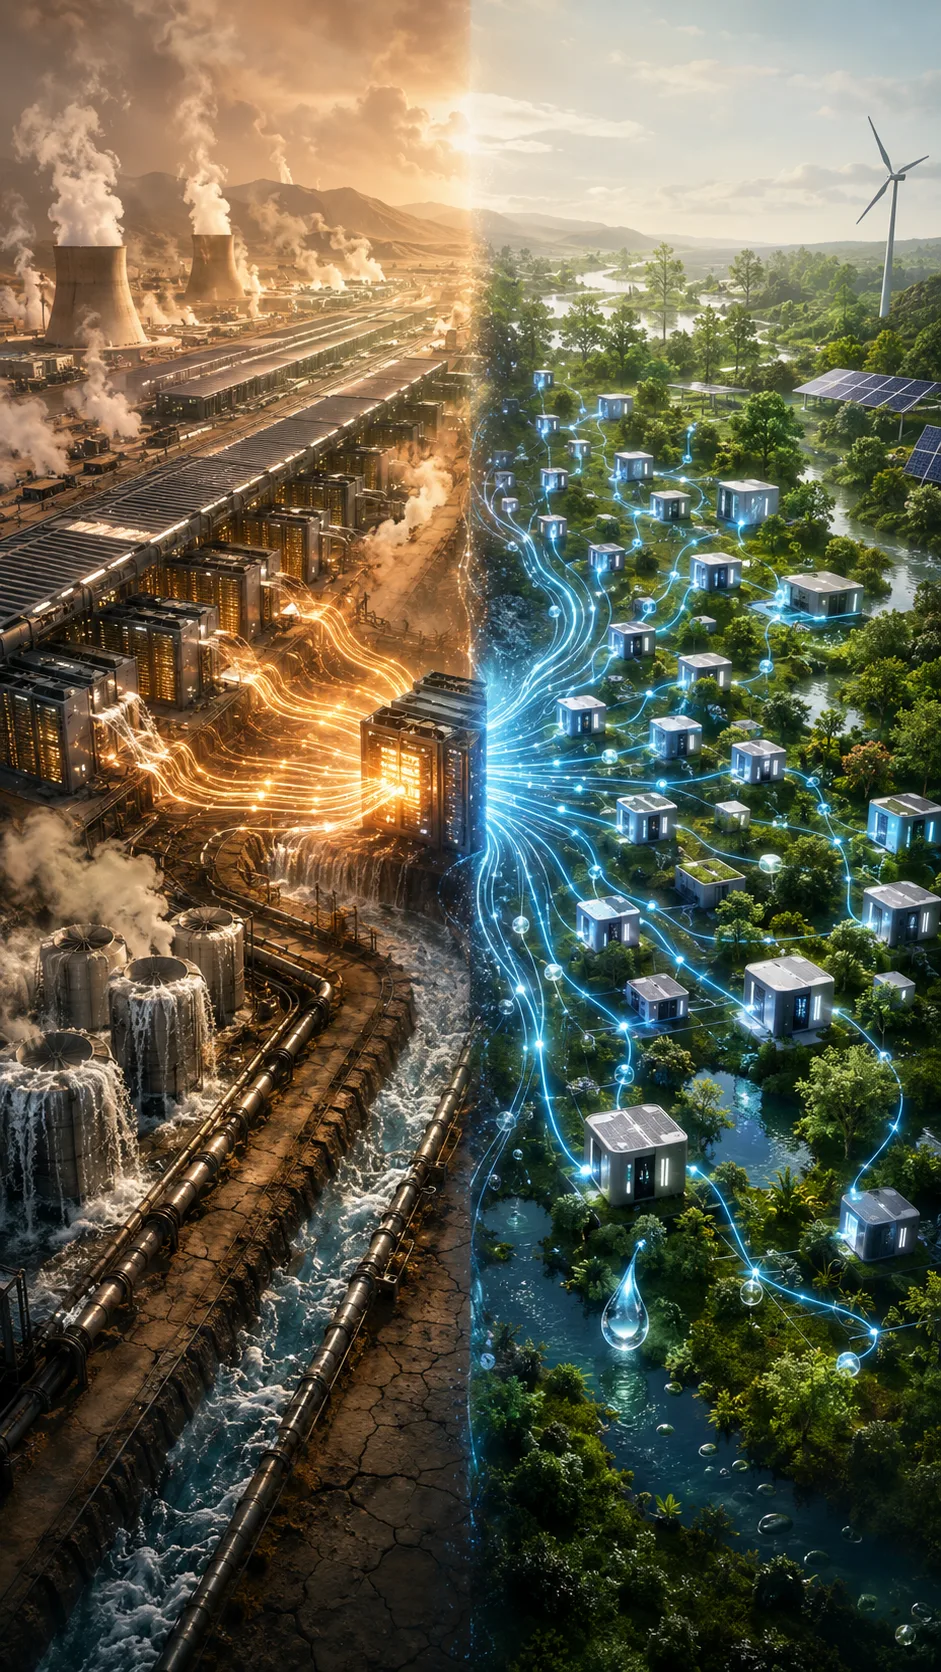
Dari perspektif operasi logistik sistem, cara kita mengklasifikasikan, mengagihkan, dan meroutingkan workload AI menentukan berapa banyak resource yang sebenarnya diperlukan. Dengan NeuralOps, tidak semua task perlu dihantar ke LLM atau GPU inference yang berat. Kami membina workflow berlapis di mana task ringan diproses melalui pipeline yang lebih cekap, manakala inference berskala besar hanya digunakan bila SLA memerlukannya.
Kaedah yang kami bangunkan boleh mencapai penggunaan tenaga AI compute yang lebih rendah hingga 90% untuk workload yang telah ditakrifkan. Apabila permintaan compute berkurangan, beban penyejukan juga turun - dan ini terus menjimatkan penggunaan air dalam operasi pusat data.
Sebab itu, ESG bukan sekadar laporan tahunan atau inisiatif tambahan. Ia dibina ke dalam arkitektur operasi kami dari awal: setiap keputusan tentang task routing, resource allocation, dan scaling policy dikira impaknya ke atas penggunaan air, tenaga, dan kos operasi jangka panjang.
https://neuralops.bond/esg/
Official Cross-Rangkaian Resource


Ruang pembaca
Apa pendapat anda?
Komen disemak sebelum diterbitkan. Email diperlukan untuk moderasi dan tidak dipaparkan kepada pembaca.
Guardado, sobre todo por 90%.
Masih fikir tentang 90%.
The framing on pusat data AI hyperscale boleh is better than expected.