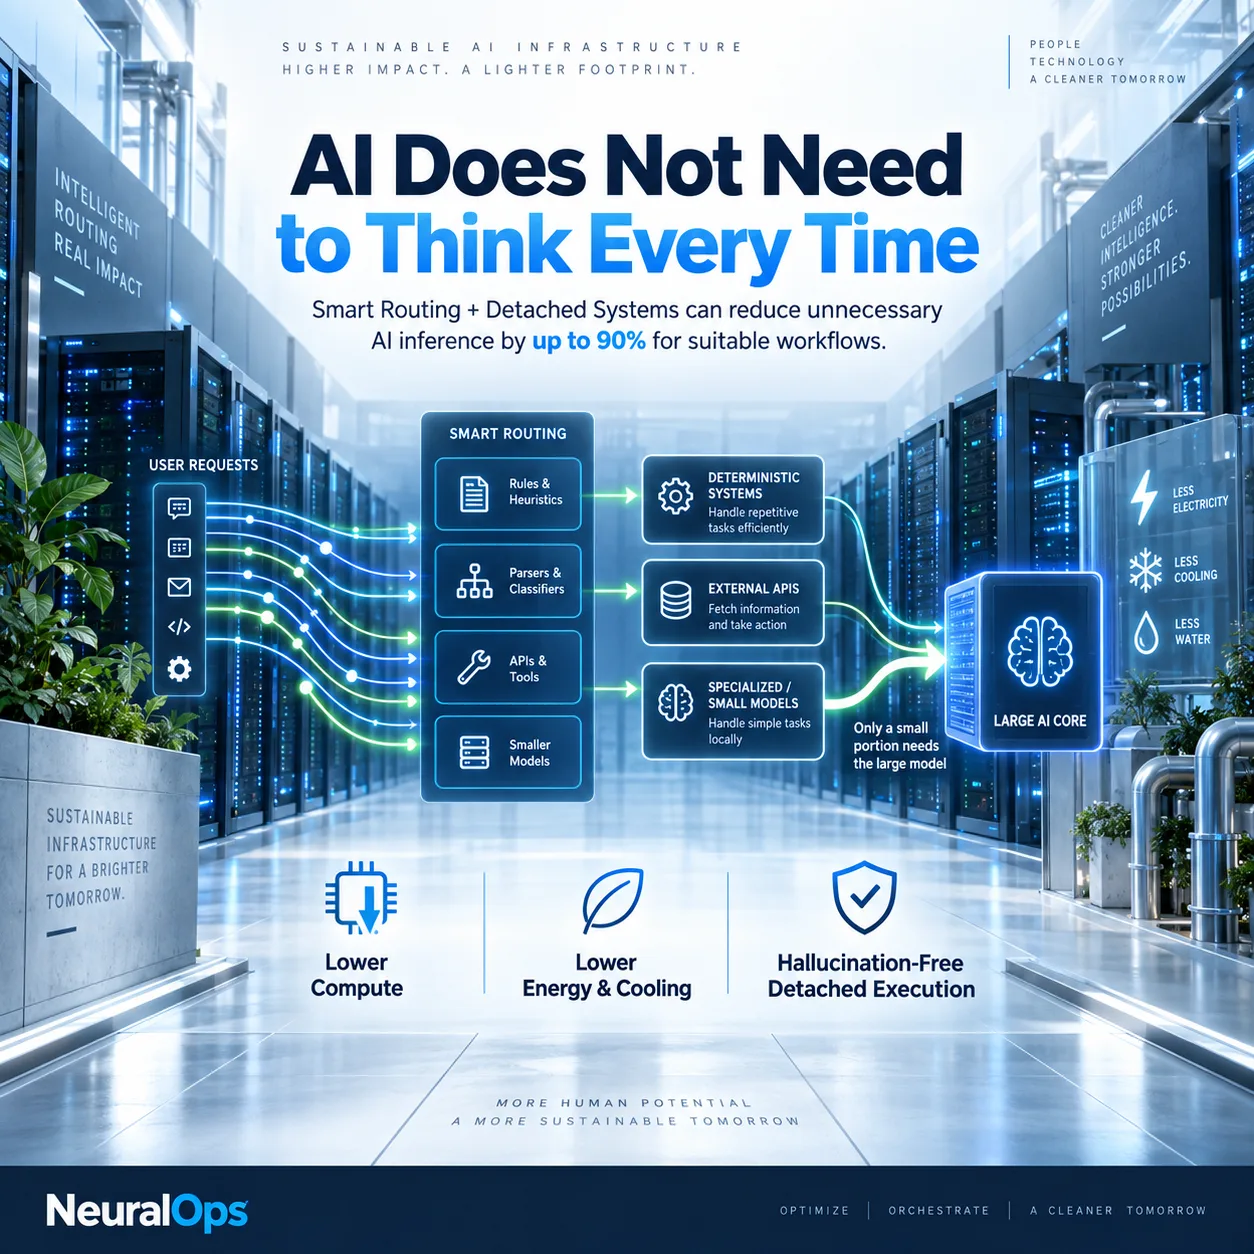
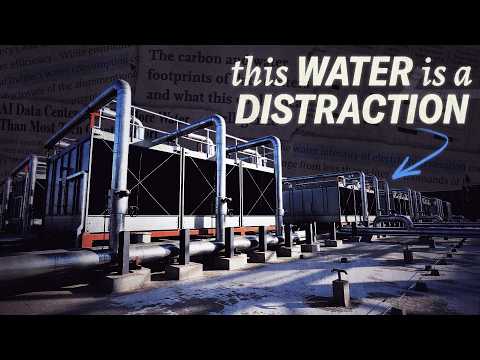
Infrastruktur AI berkembang pesat, tetapi terdapat satu lagi sisi AI yang perlu kita bincangkan: penggunaan tenaga elektrik, penyejukan dan air.
Penyelidikan terkini menunjukkan bahawa apabila satu model AI dikerahkan, inferens boleh menyumbang kira-kira 80–90% daripada penggunaan tenaganya. Setiap panggilan LLM yang tidak perlu bermaksud lebih banyak pengkomputeran GPU, lebih banyak tenaga elektrik, lebih banyak haba, dan akhirnya lebih banyak permintaan penyejukan.
Ini adalah salah satu sebab kami sedang membangunkan NeuralOps berdasarkan prinsip yang berbeza:
Bukan setiap tugas memerlukan LLM.
Dengan Smart Routing, sesuatu tugas boleh ditangani dahulu oleh peraturan, penghurai, pangkalan data, API atau model yang lebih kecil. Penaakulan LLM yang berat hanya digunakan apabila ia benar-benar diperlukan. Apabila sesuatu aliran kerja menjadi stabil, ia boleh ditukar kepada sistem deterministik terpisah yang dijalankan berulang kali tanpa memanggil LLM.
Bagi aliran kerja berulang yang sesuai, seni bina ini berpotensi mengurangkan permintaan inferens AI sebanyak hingga 90%.
Kesannya tidak terhad kepada penjimatan token.
Kurang inferens → Kurang pengkomputeran GPU → Kurang tenaga elektrik → Kurang haba → Kurang penyejukan → Permintaan air yang lebih rendah.
Terdapat manfaat lain: kebolehpercayaan.
Apabila aliran kerja terpisah tidak lagi bergantung kepada LLM semasa pelaksanaan, terdapat sifar token LLM dan sifar halusinasi LLM dalam laluan pelaksanaan tersebut. Kepintaran digunakan di mana penaakulan diperlukan, manakala sistem deterministik mengendalikan operasi yang boleh diulang.
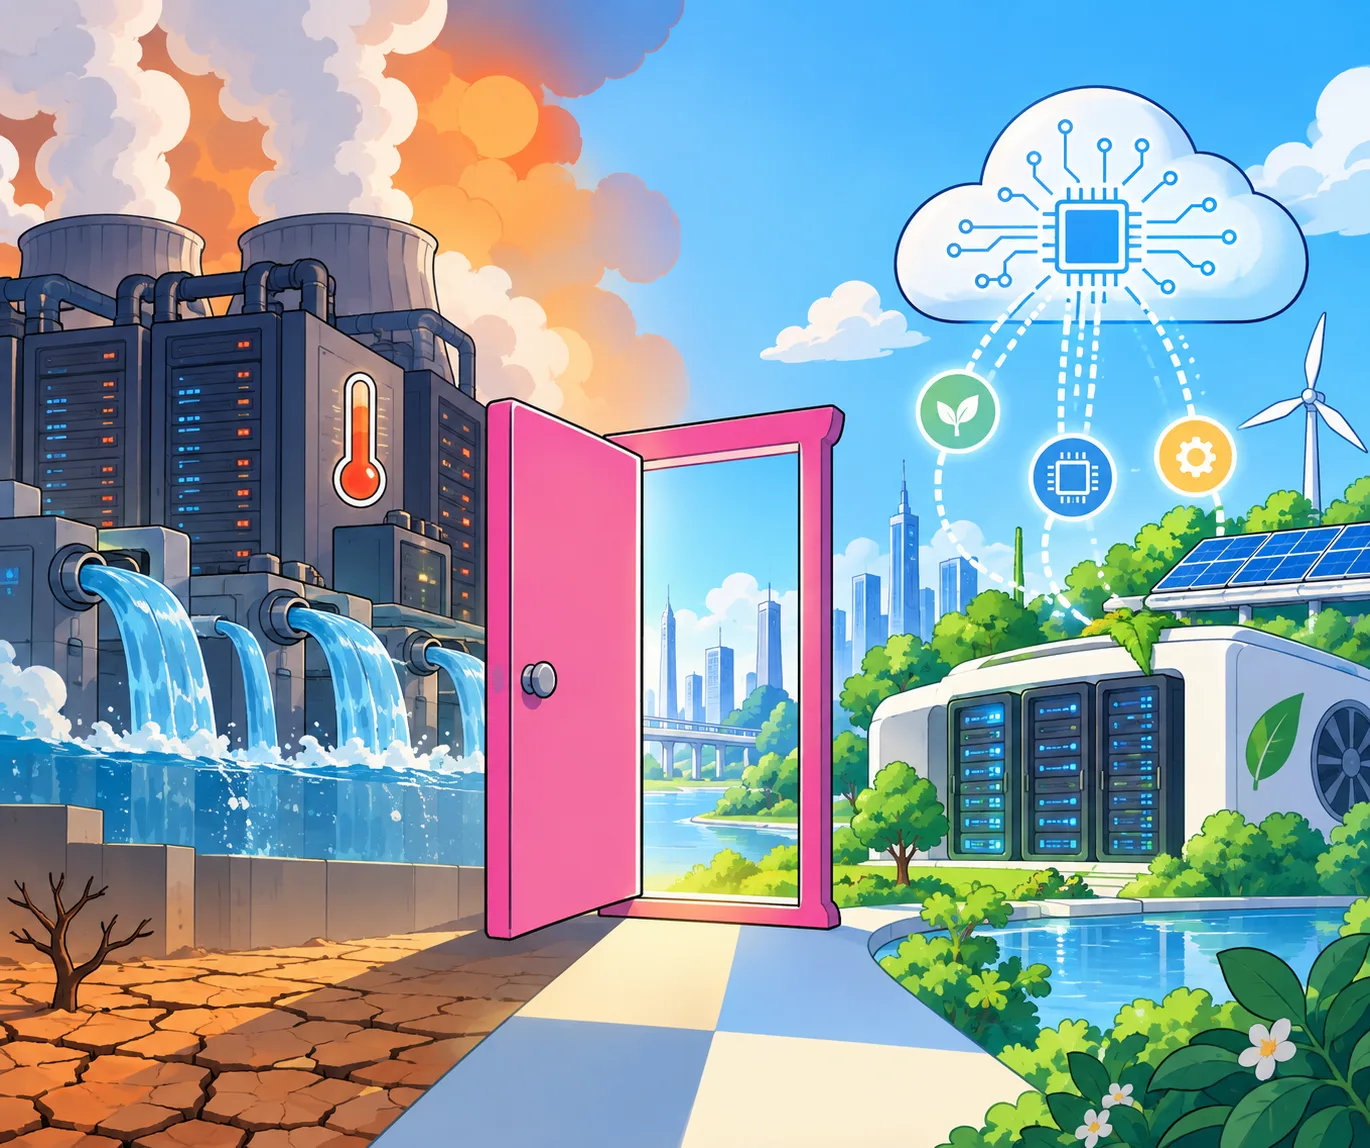
Saya percaya AI mampan tidak akan datang hanya daripada membina pusat data yang lebih cekap.
Ia juga akan datang daripada mencegah inferens AI yang tidak perlu sampai ke pusat data sejak awal.
Itulah arah yang kami teroka dengan NeuralOps:
gunakan AI apabila kepintaran diperlukan, dan gunakan sistem deterministik apabila kepintaran tidak diperlukan.
#ArtificialIntelligence #AgenticAI #NeuralOps #SovereignAI #GreenAI #MampanAI #DataCentre #AIInfrastruktur #SmartRouting #Automasi #PKS


Ruang pembaca
Apa pendapat anda?
Komen disemak sebelum diterbitkan. Email diperlukan untuk moderasi dan tidak dipaparkan kepada pembaca.
Bahagian 80 tu yang paling kena dengan saya.
Penyelidikan terkini menunjukkan bahawa is what I would forward to my boss.
Whoever wrote this actually did the work on inferens boleh menyumbang kira-kira 80–90%.
The case for ini adalah salah satu sebab is well made.
เพิ่งเคยเห็นคนเขียนเรื่อง80แบบตรงไปตรงมา
Good to finally see setiap panggilan LLM yang tidak set out this clearly.
I read this twice. Apabila sesuatu aliran kerja menjadi is the part that stuck.
The bit about sebanyak hingga 9 90% is what I keep coming back to.