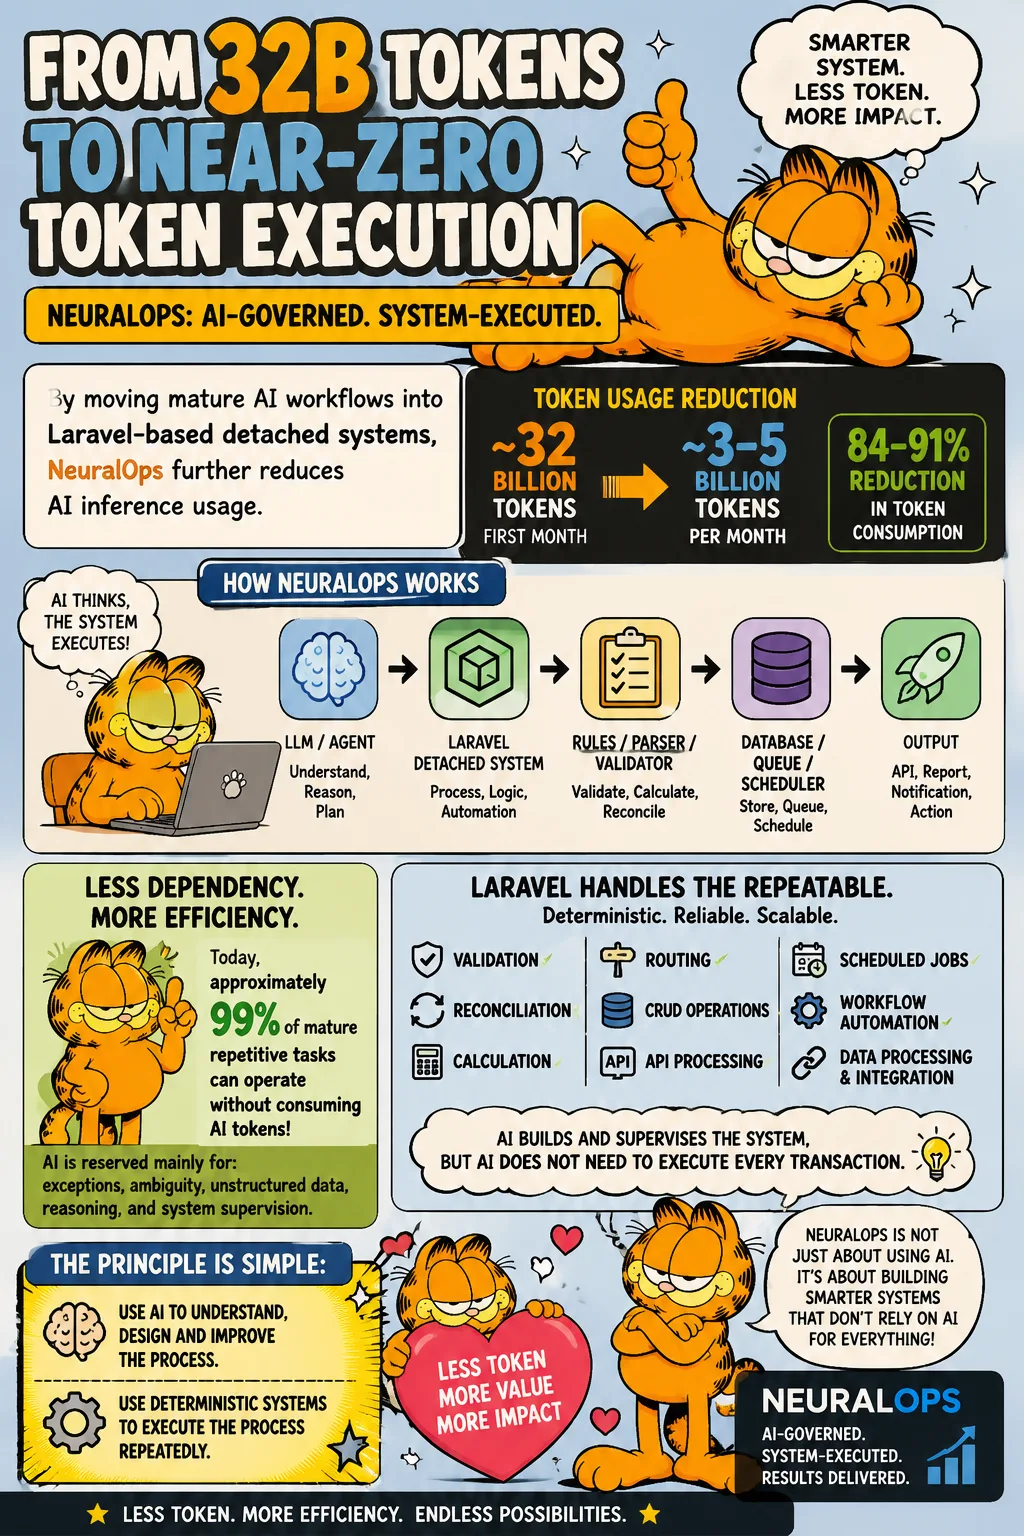
Dari sudut operasi, kami sentiasa cari cara supaya sistem AI tidak terpaksa buat inference setiap kali ada kerja berulang. Di AINNA, prinsip kerja kami mudah: biarkan AI faham dan reka proses, kemudian sistem deterministik yang jalankan proses itu berkali-kali.
Apabila workflow AI yang dah stabil dipindahkan ke sistem berasingan berasaskan Laravel, penggunaan token AI turun dengan ketara. Dalam kes kami, token usage jatuh dari kira-kira 32 billion token pada bulan pertama ke lebih kurang 3–5 billion token sebulan - penurunan anggaran 84–91% daripada penggunaan token.
Makin banyak tugas repetitif dan berstruktur yang kita migrate ke sistem Laravel berasingan, bergantungan kepada LLM inference pun makin kurang. Pada masa ini, anggaran 99% tugas berulang yang matang boleh jalan tanpa consume token AI. AI kita simpan untuk exception, data tidak berstruktur, reasoning, dan penyeliaan sistem.
Prinsip operasi kami mudah:
Guna AI untuk faham, reka dan baiki proses.
Guna sistem deterministik untuk jalankan proses berulang kali.
Inilah cara NeuralOps bergerak daripada automasi yang bergantung banyak kepada AI ke arah arkitektur AI-governed, system-executed yang lebih cekap.

Ruang pembaca
Apa pendapat anda?
Komen disemak sebelum diterbitkan. Email diperlukan untuk moderasi dan tidak dipaparkan kepada pembaca.
Orang yang tulis ni memang buat kerja rumah pasal 32.
Still thinking about lebih kurang 3–5 5 billion.
Simpan dulu, terutama karena 32.
The section on bergantungan kepada LLM inference pun is the strongest part for me.
Useful. We are dealing with penurunan anggaran 84– 84 right now.
Worth reading for jatuh dari kira-kira 32 billion alone.
Clearer than the vendor decks I get about makin banyak tugas repetitif dan.
I read this twice. anggaran 99% t 99% is the part that stuck.